Flink、Hadoop分布式計(jì)算與大數(shù)據(jù)實(shí)戰(zhàn) 從零到一解析Hadoop及其在數(shù)據(jù)挖掘與分析中的應(yīng)用
在當(dāng)今數(shù)據(jù)驅(qū)動(dòng)的時(shí)代,分布式計(jì)算已成為處理海量數(shù)據(jù)的核心技術(shù)。本文將引導(dǎo)您從零開(kāi)始,深入理解以Flink和Hadoop為代表的分布式計(jì)算框架,并聚焦于Hadoop生態(tài)系統(tǒng),探討其在數(shù)據(jù)挖掘與分析中的實(shí)戰(zhàn)應(yīng)用。
第一部分:分布式計(jì)算入門(mén)與大數(shù)據(jù)項(xiàng)目實(shí)戰(zhàn)
從0到1:理解分布式計(jì)算的核心
分布式計(jì)算的核心思想是將一個(gè)大型計(jì)算任務(wù)分解成多個(gè)子任務(wù),分配到多臺(tái)計(jì)算機(jī)(節(jié)點(diǎn))上并行處理,最后匯果。這種模式突破了單機(jī)在存儲(chǔ)和計(jì)算能力上的限制,使得處理PB甚至EB級(jí)別的數(shù)據(jù)成為可能。
大數(shù)據(jù)項(xiàng)目實(shí)戰(zhàn)的一般流程
一個(gè)典型的大數(shù)據(jù)項(xiàng)目通常遵循以下階段:
- 需求分析與數(shù)據(jù)收集:明確業(yè)務(wù)目標(biāo),確定數(shù)據(jù)來(lái)源(如日志、數(shù)據(jù)庫(kù)、傳感器等)。
- 數(shù)據(jù)存儲(chǔ):使用HDFS、HBase等分布式存儲(chǔ)系統(tǒng)來(lái)存放海量原始數(shù)據(jù)。
- 數(shù)據(jù)處理與計(jì)算:這是核心環(huán)節(jié),利用MapReduce、Spark或Flink等計(jì)算框架對(duì)數(shù)據(jù)進(jìn)行清洗、轉(zhuǎn)換、聚合等操作。
- 數(shù)據(jù)挖掘與分析:在處理好數(shù)據(jù)的基礎(chǔ)上,應(yīng)用機(jī)器學(xué)習(xí)、統(tǒng)計(jì)分析算法,挖掘數(shù)據(jù)價(jià)值,生成洞察。
- 結(jié)果可視化與應(yīng)用:將分析結(jié)果通過(guò)報(bào)表、儀表盤(pán)等形式呈現(xiàn),并反饋到業(yè)務(wù)決策或產(chǎn)品中。
Flink與Hadoop的定位
- Hadoop:是一個(gè)開(kāi)源的、成熟的分布式系統(tǒng)基礎(chǔ)架構(gòu),其核心是HDFS(分布式文件系統(tǒng))和MapReduce(分布式計(jì)算模型)。它更適合處理離線(xiàn)、批量的海量數(shù)據(jù)。
- Flink:是一個(gè)新興的流處理框架,它實(shí)現(xiàn)了真正的流批一體,即能以同一套API處理無(wú)界流數(shù)據(jù)和有界批數(shù)據(jù)。它在實(shí)時(shí)計(jì)算、低延遲處理方面優(yōu)勢(shì)顯著。
在實(shí)際項(xiàng)目中,兩者常協(xié)同工作,例如用Hadoop HDFS存儲(chǔ)歷史數(shù)據(jù),用Flink進(jìn)行實(shí)時(shí)流處理。
第二部分:Hadoop生態(tài)系統(tǒng)深度介紹
Hadoop不僅僅指代MapReduce,它已發(fā)展成一個(gè)龐大的生態(tài)系統(tǒng)。
- 核心組件:
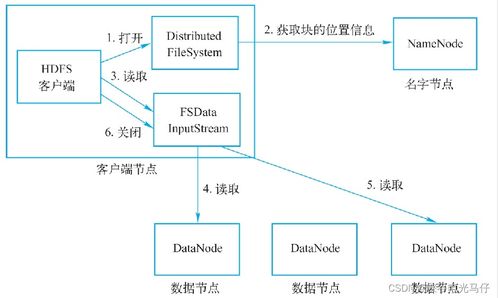
- HDFS:高容錯(cuò)、高吞吐量的分布式文件系統(tǒng),是數(shù)據(jù)存儲(chǔ)的基石。
- MapReduce:編程模型,將計(jì)算過(guò)程分為Map(映射)和Reduce(歸約)兩個(gè)階段,適合處理復(fù)雜的批量數(shù)據(jù)。
- YARN:資源調(diào)度與管理框架,負(fù)責(zé)集群資源的管理和作業(yè)調(diào)度,是Hadoop2.0后的“操作系統(tǒng)”。
- 外圍重要組件:
- Hive:基于Hadoop的數(shù)據(jù)倉(cāng)庫(kù)工具,提供類(lèi)SQL查詢(xún)功能,將SQL語(yǔ)句轉(zhuǎn)化為MapReduce任務(wù)執(zhí)行,降低了使用門(mén)檻。
- HBase:分布式、列式存儲(chǔ)的NoSQL數(shù)據(jù)庫(kù),支持實(shí)時(shí)讀寫(xiě)和隨機(jī)訪(fǎng)問(wèn)海量數(shù)據(jù)。
- Spark:基于內(nèi)存計(jì)算的通用計(jì)算引擎,速度遠(yuǎn)超MapReduce,支持流處理、機(jī)器學(xué)習(xí)等多種計(jì)算范式,常與Hadoop集成。
- Sqoop:用于在Hadoop和關(guān)系型數(shù)據(jù)庫(kù)之間高效傳輸數(shù)據(jù)的工具。
- Flume:分布式、高可用的日志收集系統(tǒng)。
第三部分:基于Hadoop的數(shù)據(jù)挖掘與分析實(shí)戰(zhàn)
Hadoop為數(shù)據(jù)挖掘與分析提供了強(qiáng)大的數(shù)據(jù)基礎(chǔ)和計(jì)算能力。
1. 數(shù)據(jù)預(yù)處理
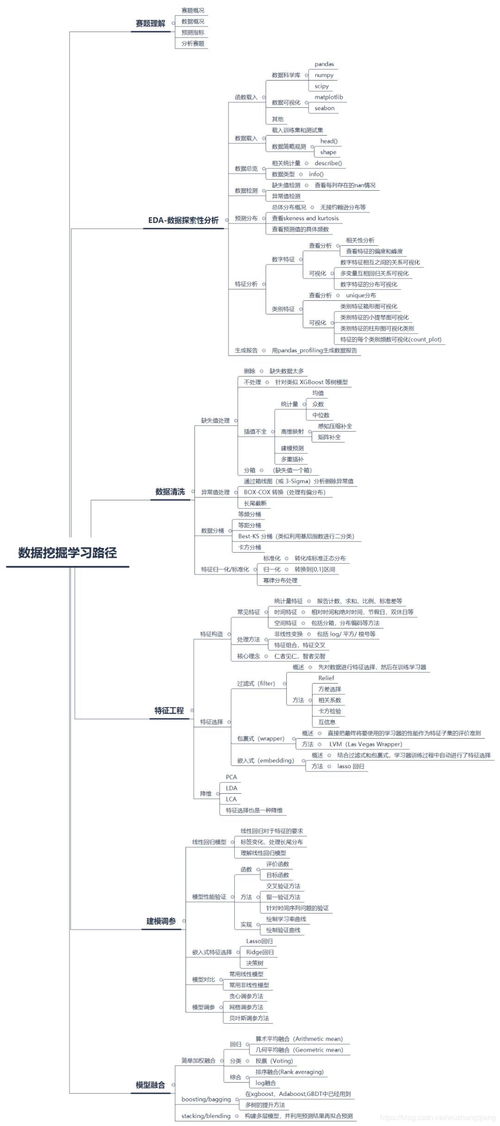
數(shù)據(jù)挖掘80%的工作在于數(shù)據(jù)預(yù)處理。利用MapReduce或Hive,我們可以高效地:
- 數(shù)據(jù)清洗:過(guò)濾無(wú)效、錯(cuò)誤記錄。
- 數(shù)據(jù)集成:將來(lái)自不同源的數(shù)據(jù)(如日志、業(yè)務(wù)數(shù)據(jù)庫(kù))合并。
- 數(shù)據(jù)轉(zhuǎn)換:進(jìn)行規(guī)范化、聚合等操作,為后續(xù)分析做準(zhǔn)備。
2. 挖掘與分析場(chǎng)景
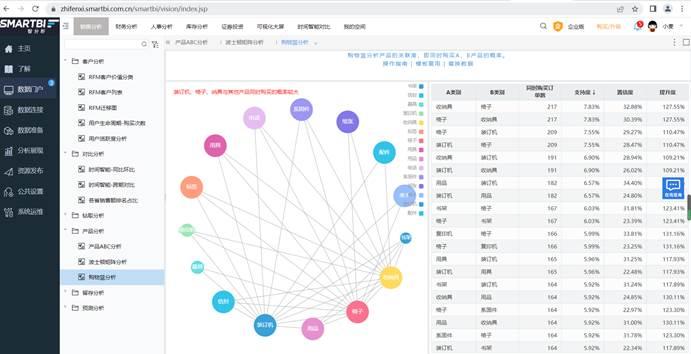
- 關(guān)聯(lián)規(guī)則挖掘:例如,在電商日志中,使用類(lèi)MapReduce的并行算法(如FP-Growth的并行實(shí)現(xiàn))分析“購(gòu)物籃”,找出“購(gòu)買(mǎi)了A商品的用戶(hù)很可能也購(gòu)買(mǎi)B商品”的規(guī)則。
- 聚類(lèi)分析:利用Mahout(Hadoop上的機(jī)器學(xué)習(xí)庫(kù))或Spark MLlib中的K-Means等算法,對(duì)用戶(hù)進(jìn)行分群,實(shí)現(xiàn)客戶(hù)細(xì)分。
- 統(tǒng)計(jì)分析:使用Hive SQL對(duì)全量歷史數(shù)據(jù)進(jìn)行多維度的聚合統(tǒng)計(jì)(如PV/UV、銷(xiāo)售總額、用戶(hù)留存率),生成周期性報(bào)表。
- 機(jī)器學(xué)習(xí)模型訓(xùn)練:對(duì)于超大規(guī)模的訓(xùn)練數(shù)據(jù)集,可以在Hadoop集群上分布式地訓(xùn)練分類(lèi)、回歸或推薦模型。
3. 實(shí)戰(zhàn)架構(gòu)示例
一個(gè)經(jīng)典的離線(xiàn)分析Pipeline可能是:日志文件 -> Flume采集 -> HDFS存儲(chǔ) -> Hive/MapReduce進(jìn)行ETL和預(yù)處理 -> Hive/Spark進(jìn)行數(shù)據(jù)挖掘與分析 -> 結(jié)果導(dǎo)出至關(guān)系型數(shù)據(jù)庫(kù)或HBase -> 前端可視化展示。
###
從理解分布式計(jì)算原理,到掌握Hadoop生態(tài)的核心組件,再到將其應(yīng)用于實(shí)際的數(shù)據(jù)挖掘與分析任務(wù),是一個(gè)系統(tǒng)的學(xué)習(xí)與實(shí)踐過(guò)程。Hadoop以其穩(wěn)定、成熟的特性,依然是處理海量離線(xiàn)數(shù)據(jù)的首選平臺(tái),為深入的數(shù)據(jù)價(jià)值挖掘提供了堅(jiān)實(shí)的基礎(chǔ)。而結(jié)合Flink等實(shí)時(shí)計(jì)算引擎,更能構(gòu)建起覆蓋實(shí)時(shí)與離線(xiàn)場(chǎng)景的完整大數(shù)據(jù)解決方案,真正賦能數(shù)據(jù)驅(qū)動(dòng)決策。
如若轉(zhuǎn)載,請(qǐng)注明出處:http://www.cqu9.cn/product/3.html
更新時(shí)間:2026-09-03 00:01:17